均数标准差符号:x̄±s与μ、σ怎么写
更新于
均数标准差符号分两套:样本均数写 x̄(读作「x 拔」),样本标准差写 s,论文和检验报告里常写成 x̄ ± s;总体均数写 μ,总体标准差写 σ。在公式里输入时,x̄ 是 \bar{x},± 是 \pm,μ 和 σ 分别是 \mu 和 \sigma。下面先给对照表,再讲 x̄ ± s 的规范写法和几处常见差错。
速查表:样本与总体的符号对照
| 符号 | 含义 | LaTeX 写法 | 本站编辑器输入方式 |
|---|---|---|---|
| x̄ | 样本均数 | \bar{x} |
「LaTeX」模式输入命令 |
| s | 样本标准差 | s |
直接打字母 |
| s² | 样本方差 | s^2 |
输完 ^2 自动退出上标 |
| n | 样本量 | n |
直接打字母 |
| μ | 总体均数 | \mu |
符号面板「希腊」页签 |
| σ | 总体标准差 | \sigma |
符号面板「希腊」页签 |
| σ² | 总体方差 | \sigma^2 |
点 σ 后接 ^2 |
| N | 总体中的个体数 | N |
直接打字母 |
| x̄ ± s | 均数 ± 标准差 | \bar{x}\pm s |
± 在「运算」页签 |
| s_x̄ | 均数的标准误 | s_{\bar{x}} |
下标里再写 x 拔 |
| σ̂ | 总体标准差的估计值 | \hat{\sigma} |
「LaTeX」模式输入命令 |
| SD、SEM | 英文文献里的标准差、标准误 | \mathrm{SD} |
缩写用直立体 |
表里前 8 行是两套基本符号,后 4 行是报告和论文里常见的延伸写法。输入 \sigma 这类命令时,符号随打随显,按空格结束命令再接着写。
x̄ ± s 在报告里怎么写
「均数 ± 标准差」是描述正态或近似正态数据最常见的格式。举一组数:5 名受试者的收缩压为 118、122、125、130、115 mmHg。
- 均数:五个数之和 610 除以 5,x̄ = 122.0。
- 离均差平方和:各数减 122 得 −4、0、3、8、−7,平方后相加得 138。
- 样本标准差:138 除以 n − 1 = 4 得方差 34.5,开方得 s ≈ 5.9。
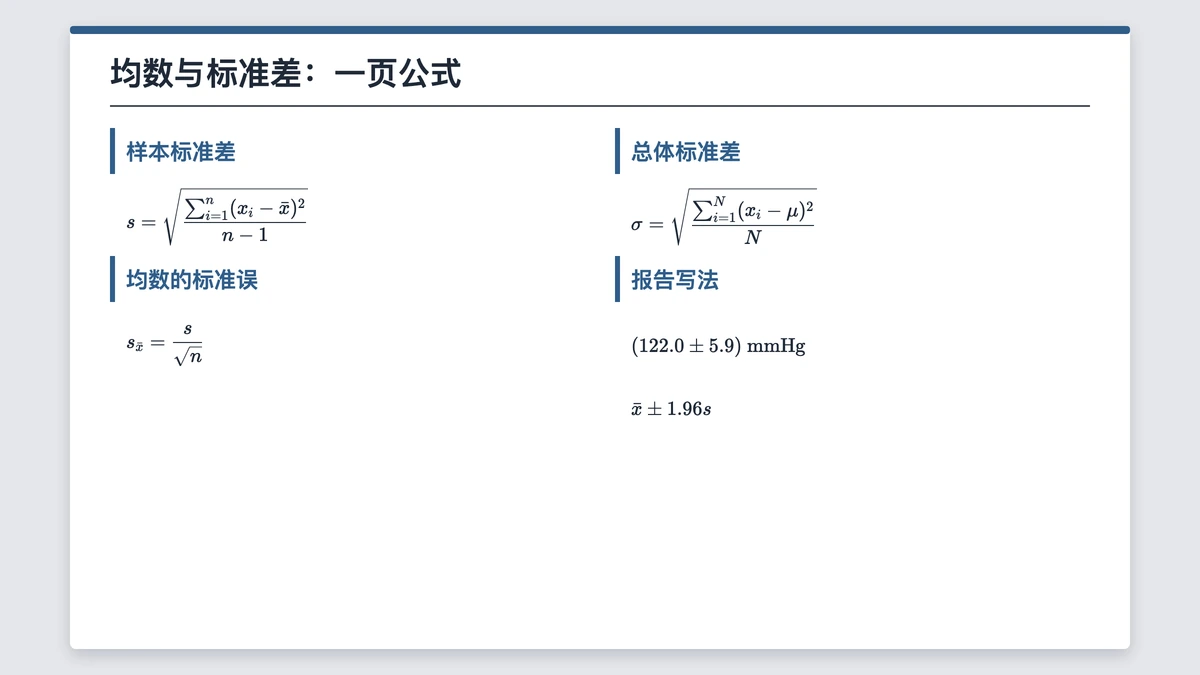
写进正文时是「收缩压为 (122.0 ± 5.9) mmHg」。单位放在括号外,说明单位同时作用于均数和标准差;均数与标准差保留相同的小数位数。样本标准差的公式如下,分母是 n − 1:
s=\sqrt{\frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}}
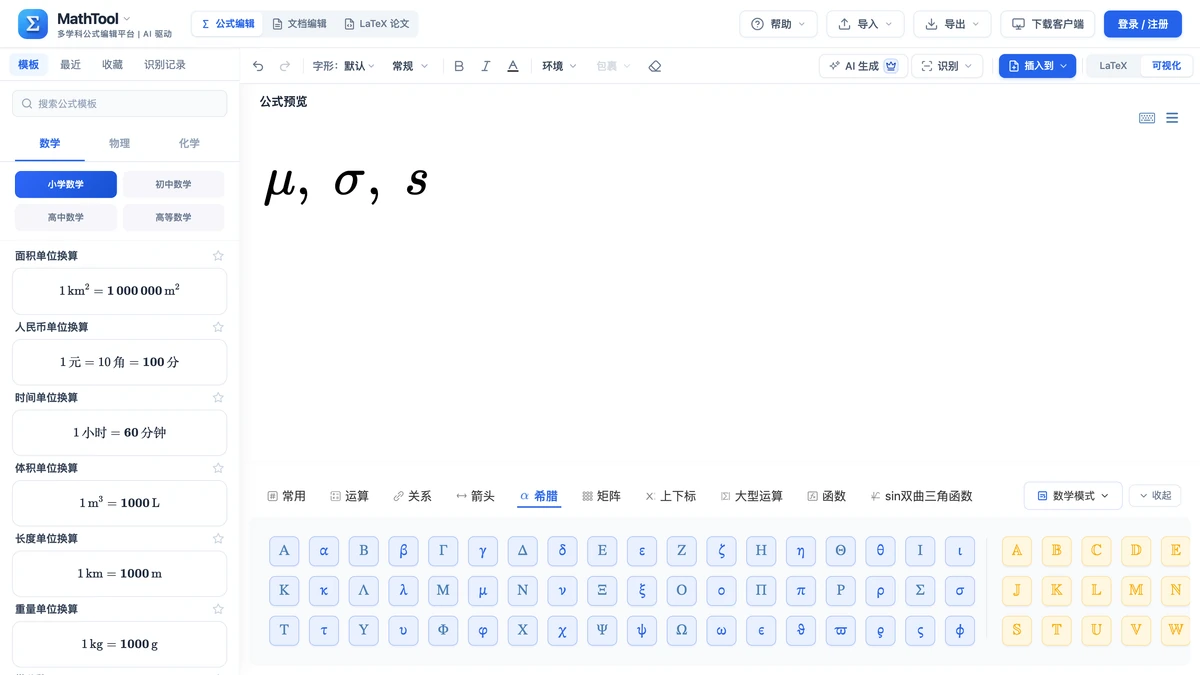
在编辑器里,μ、σ 从「希腊」页签点,± 在「运算」页签,x̄ 用命令输入。下图是在编辑区点出 μ、σ 并写上 s 后停在「希腊」页签的样子:
总体参数 μ、σ 的写法
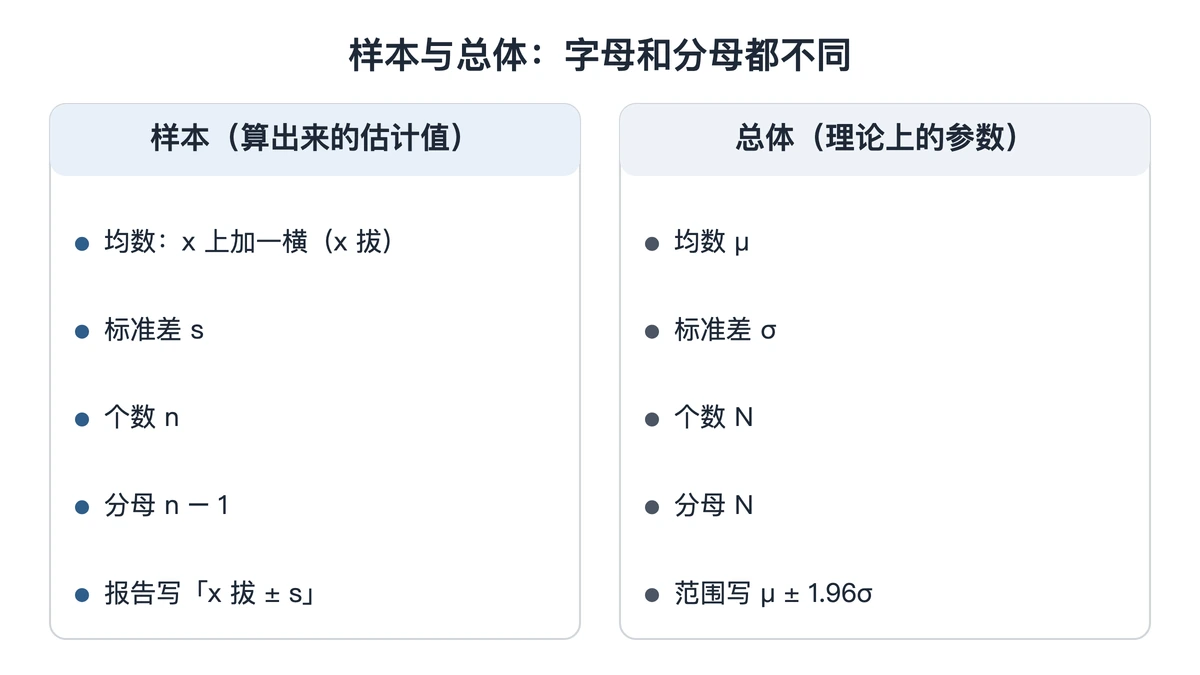
总体标准差的定义里分母是 N,并且用总体均数 μ 代替 x̄。两条公式放在一起,差别在字母和分母上:
\sigma=\sqrt{\frac{\sum_{i=1}^{N}(x_i-\mu)^2}{N}}
实际研究里 μ 和 σ 通常未知,所以正文描述样本时写 x̄ ± s,讲理论分布时才写 μ、σ,例如「若 X 服从均数为 μ、标准差为 σ 的正态分布」。正态分布下约 95% 的个体值落在 μ ± 1.96σ 之间,用样本估计时写成 x̄ ± 1.96s,这是医学参考值范围的常见写法。
四处常见差错
- 把标准误当标准差。 标准误 s_x̄ = s ÷ √n,上例约为 5.9 ÷ √5 ≈ 2.6,比标准差小得多;表格标题写「x̄ ± s」,数据却填的是标准误,读者会低估数据的离散程度。
- 样本数据用了 σ。 从样本算出来的标准差写 s,写 σ 等于声称知道总体参数。
- 漏了均数上的横线。 写成 x ± s,x 就只是变量本身,不是均数;x̄ 的横线只盖一个字母,用
\bar{x}即可。 - 单位与小数位不统一。 写成 122.0 ± 5.87 mmHg 或 122 ± 5.9,位数不一致;有单位时整体加括号。
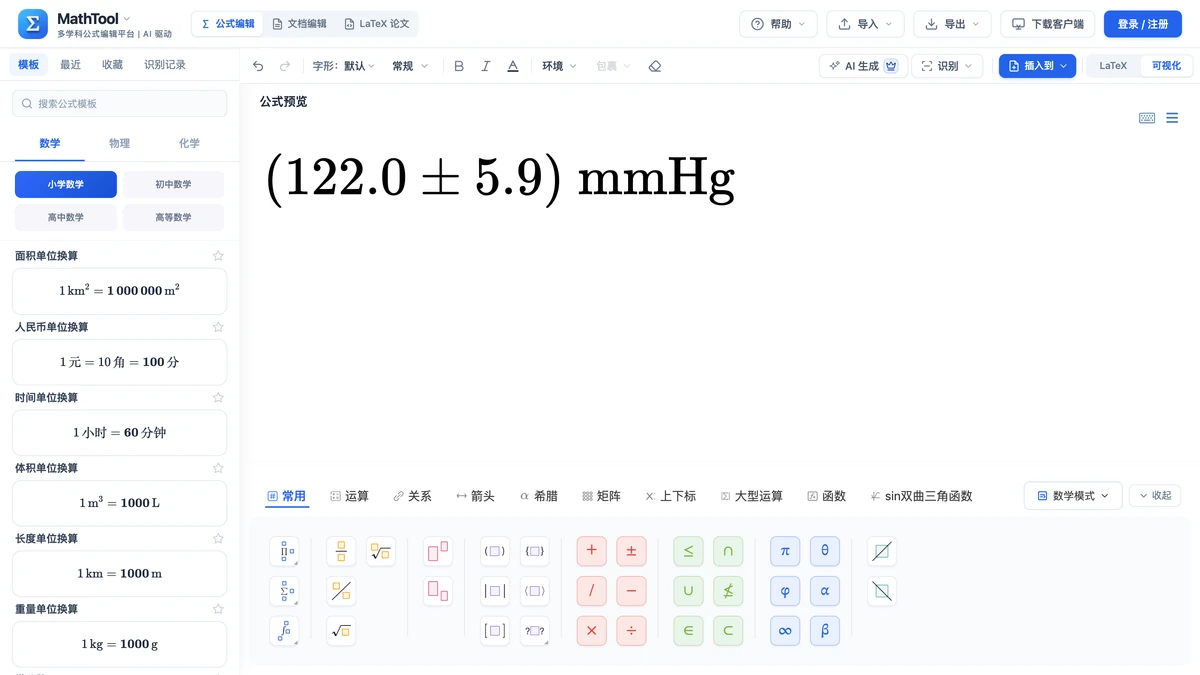
报告里的第一张统计表,不妨先把表头写成「(x̄ ± s)」、单位写在括号外,在编辑区里输入 \bar{x} 得到 x̄,再点「运算」页签的 ±,写好后对照原始数据逐格核对,确认填进去的是标准差而不是标准误。
延伸阅读
- 数学符号复制:运算、关系、集合符号分组复制
- 求和求积符号怎么读:∑ 与 ∏ 的读法和上下限写法
- Word弧的数学符号:弧AB上方加弧线怎么输入
常见问题
- 样本和总体的符号为什么不同?
- 总体的均数和标准差是固定但通常未知的参数,用希腊字母 μ 和 σ 表示;样本是从总体里抽出来的一部分,算出的均数和标准差会随抽样变化,是对参数的估计,用拉丁字母 x 拔和 s 表示。两套符号分开写,读者一眼就知道这个数是算出来的估计值还是理论上的参数。样本标准差的分母是 n 减 1,总体标准差的分母是 N,这也是两者不能混用的原因。