标准差计算步骤:总体与样本标准差的区别
更新于
标准差计算步骤一共六步:求平均数,求每个数与平均数的差,把差平方,把平方加起来,除以个数,最后开平方。总体标准差与样本标准差只在第五步不同:总体除以 N,样本除以 n − 1。数据就是全部研究对象时用总体标准差,用一部分数据去估计整体时用样本标准差,同一组数据算出来样本标准差不会更小,数据少时明显更大。
两个公式与区别速查
\sigma=\sqrt{\frac{1}{N}\sum_{i=1}^{N}(x_i-\mu)^2}
s=\sqrt{\frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}}
| 对比项 | 总体标准差 | 样本标准差 |
|---|---|---|
| 记号 | σ,平均数记作 μ | s,平均数记作 x̄ |
| 第五步的分母 | N(全部个数) | n − 1 |
| 什么时候用 | 全班成绩全部在手,只描述这个班 | 抽 5 人估计全年级 |
| 同一组数据的结果 | 不大于样本标准差 | 不小于总体标准差,数据少时明显更大 |
为什么样本要除以 n − 1?样本平均数是用这 n 个数自己算出来的,n 个离差加起来恒等于 0,真正能自由变动的只有 n − 1 个。直接除以 n 会系统地把总体的波动估小,除以 n − 1 之后,样本方差才是总体方差的无偏估计。
分步手算:五次测验成绩
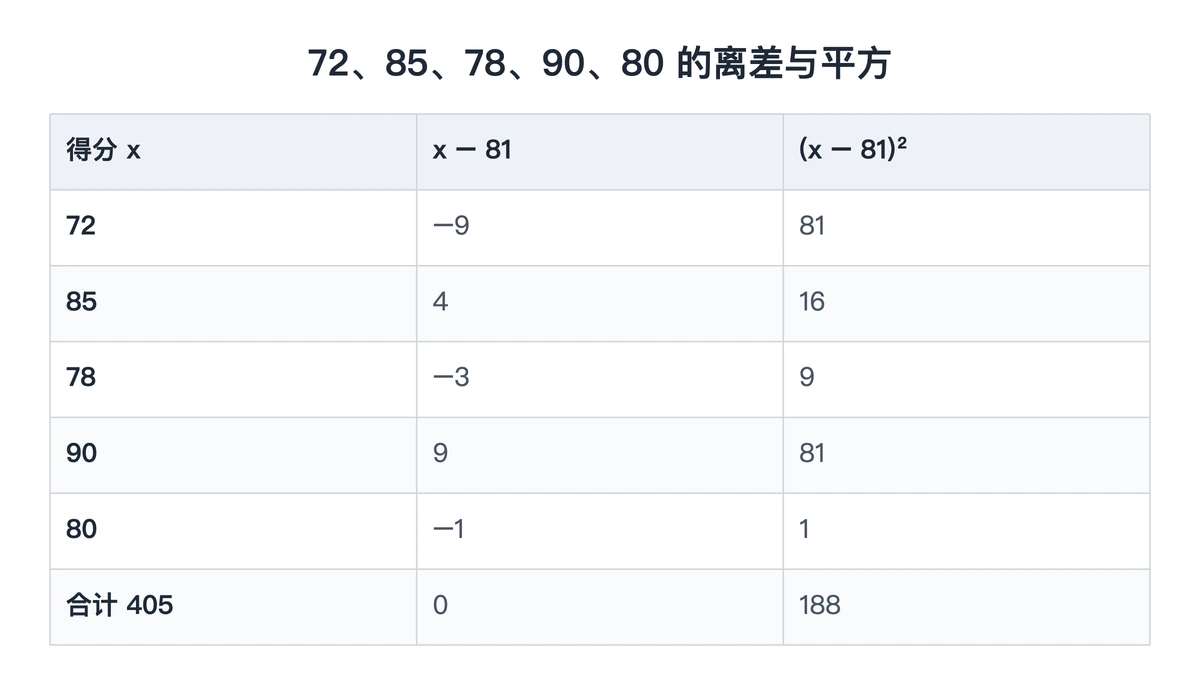
某同学五次数学测验得分 72、85、78、90、80。先把每一步的中间数排成表,每一列都能单独核对:
| 得分 x | 与平均数的差 x − 81 | 差的平方 |
|---|---|---|
| 72 | −9 | 81 |
| 85 | 4 | 16 |
| 78 | −3 | 9 |
| 90 | 9 | 81 |
| 80 | −1 | 1 |
| 合计 405 | 0 | 188 |
- 求平均数:405 ÷ 5 = 81。
- 求离差:每个数减 81,这一列加起来必须是 0,不为 0 说明前面算错了。
- 平方并求和:81 + 16 + 9 + 81 + 1 = 188。
- 总体:方差 188 ÷ 5 = 37.6,标准差 σ = √37.6 ≈ 6.13。
- 样本:方差 188 ÷ 4 = 47,标准差 s = √47 ≈ 6.86。
换一种算法核对总体方差:各数平方和 5184 + 7225 + 6084 + 8100 + 6400 = 32993,除以 5 得 6598.6,减去平均数的平方 6561,同样是 37.6。
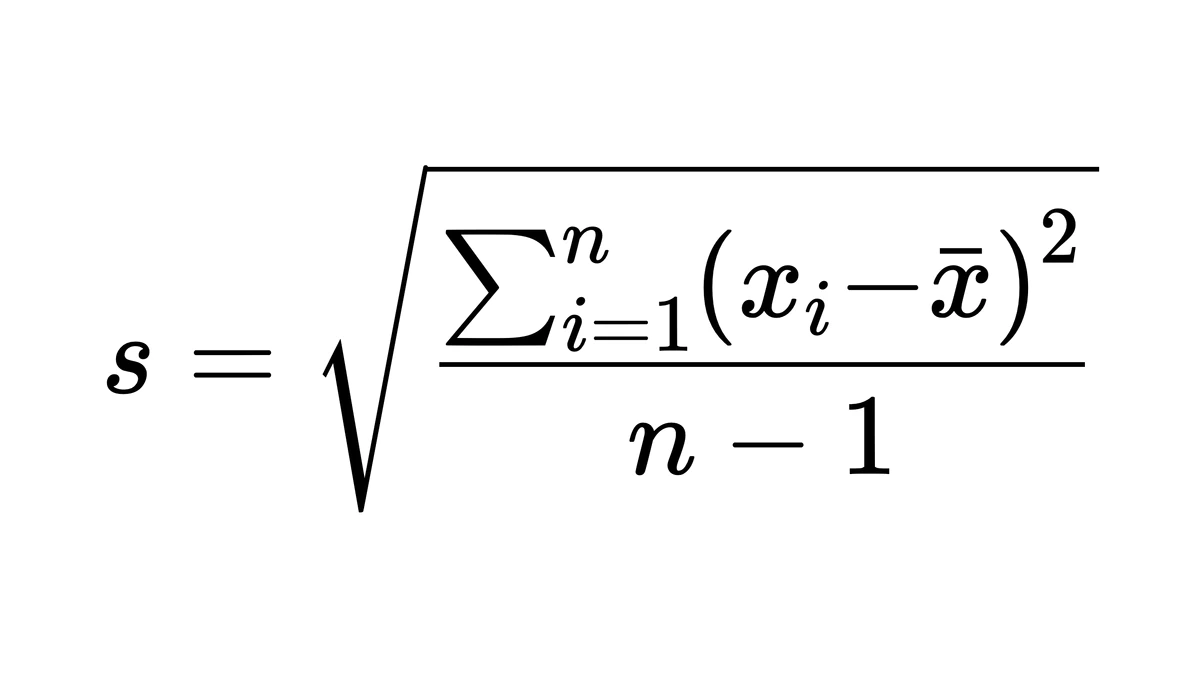
分母取 N 还是 n − 1:按场景判断
- 题目给了公式:照题目给的写。中学教材统计章节的方差公式分母写的是 n,做中学练习按教材来。
- 描述已知的全体:一个班 45 人的成绩全在手,要说明这个班成绩的波动,用 N。
- 用抽样估计整体:从全年级抽 5 份试卷估计全年级的波动,用 n − 1,大学概率统计课和统计软件默认也是它。
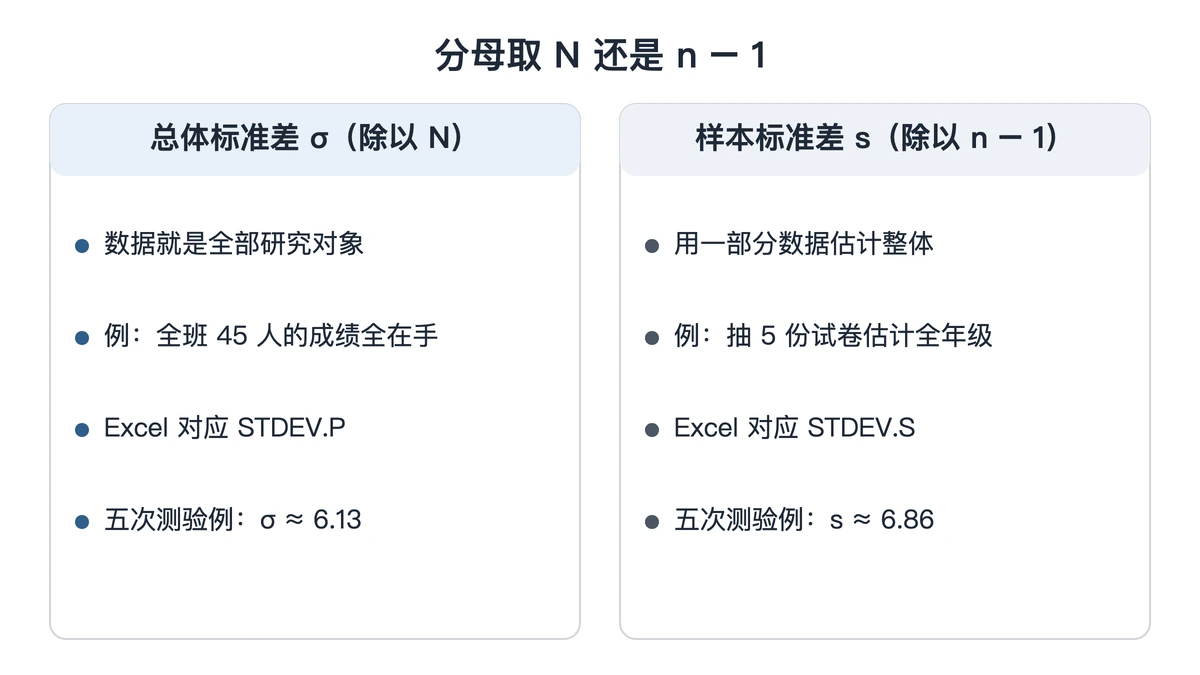
样本很小时两者差得明显:上面 5 个数,6.13 与 6.86 相差约 0.73 分;数据有 500 个时,除以 500 和除以 499 几乎没有差别。
常见错误
- 离差直接相加:第二步那一列的和恒为 0,所以一定要先平方再相加。
- 漏了开方:37.6 是方差,单位是「分的平方」;标准差要开方回到「分」,才能和原数据比较。
- 平均数先取近似:平均数除不尽时先保留足够位数,四舍五入后再求离差会把误差放大。
- 两个分母混用:同一份作业里前面用 n、后面用 n − 1,结论就对不上了。
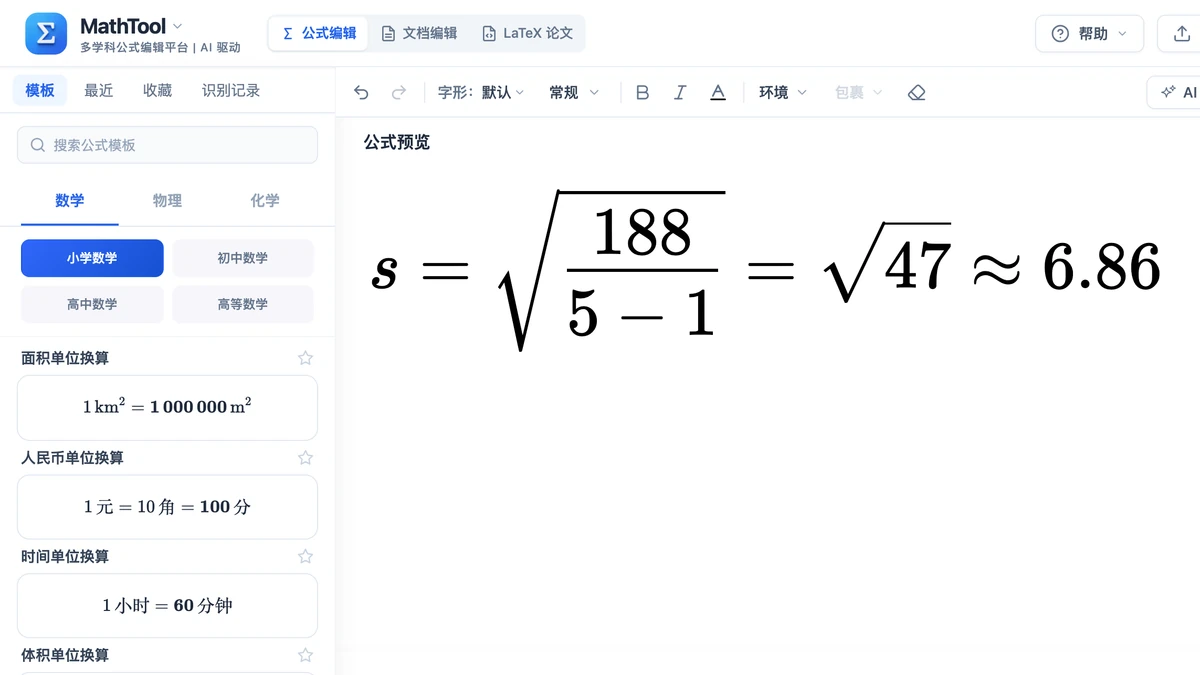
在编辑器里写这两个公式时,σ 用 \sigma,μ 用 \mu,平均数的横线用 \bar{x},根号用 \sqrt{};输入命令后按空格结束,就会变成对应的符号。要把公式做成图片放进课件,可以参考公式图片制作;概率统计大题里期望与方差的算法,可以看高中数学解题方法里的二项分布例题。
可以现在试一次:把自己最近五次测验的分数照上面的表格逐列算出来,再把最后的 σ 与 s 两个式子写进编辑区,看看离差那一列是不是正好加到 0;两行式子排好后把公式工具栏右端的「LaTeX / 可视化」开关切到「LaTeX」模式,能看到每个符号对应的源码,下次照着改数字即可。
延伸阅读
常见问题
- Excel用哪个函数?
- 据 Excel 自带的函数说明(截至2026年9月),总体标准差用 STDEV.P,样本标准差用 STDEV.S;旧名 STDEV 仍可用,算法与 STDEV.S 相同,分母是 n 减 1。对应的方差函数是 VAR.P 和 VAR.S。手里的数据就是全部对象时选带 P 的,只是抽出来的一部分时选带 S 的,算完可以拿本文的手算结果核对一遍。